Mỗi năm, lũ lụt ảnh hưởng đến nhiều người trên toàn thế giới hơn bất kỳ thảm họa thiên nhiên nào khác. Việc dự báo chính xác lưu lượng dòng chảy – tức dự đoán lượng nước sẽ chảy qua một con sông trong những ngày tới – là yếu tố then chốt để đưa ra cảnh báo kịp thời, quản lý các hồ chứa và bảo vệ tính mạng con người.
Trong hơn 15 năm qua, ECMWF đã cung cấp nền tảng tính toán cốt lõi cho Hệ thống Cảnh báo Lũ lụt Châu Âu và Toàn cầu (EFAS và GloFAS). Hệ thống này kết hợp các dự báo thời tiết với những mô hình thủy văn dựa trên quy trình – vốn là các mô phỏng vận hành theo nguyên lý vật lý, sử dụng các phương trình toán học để mô tả sự di chuyển của nước trên bề mặt địa hình. Hiện nay, chúng tôi đang nghiên cứu cách thức mà học máy (machine learning) có thể bổ trợ cho các năng lực này.
Trong một nghiên cứu mới, chúng tôi giới thiệu "Trí tuệ nhân tạo cho Lũ lụt" (Artificial Intelligence for Floods - AIFL), một mô hình dự báo lưu lượng dòng chảy toàn cầu. Mô hình này học trực tiếp từ dữ liệu và, quan trọng hơn, học cách thích ứng với thực tế của công tác dự báo thời tiết vận hành.
Công trình này đóng góp vào sáng kiến "Destination Earth" (DestinE) của Ủy ban Châu Âu. Trong khuôn khổ DestinE, ECMWF cùng nhiều đối tác đang xây dựng các mô hình dựa trên dữ liệu cho toàn bộ hệ thống Trái Đất. AIFL tập trung vào thành phần thủy văn, bổ sung cho các nỗ lực song song liên quan đến khí quyển, đại dương, băng biển, sóng và đất liền, đồng thời góp phần đặt nền móng cho một mô hình hệ thống Trái Đất hoàn chỉnh dựa trên học máy.
Thách thức: huấn luyện dựa trên dữ liệu quá khứ, dự báo trong thời gian thực
Các mô hình học máy trong lĩnh vực thủy văn thường được huấn luyện và vận hành dựa trên dữ liệu tái phân tích khí quyển (atmospheric reanalysis data). Đây là các dữ liệu tái dựng thời tiết trong quá khứ theo dạng lưới, đảm bảo tính nhất quán về thời gian và được củng cố bằng các quan sát thực tế thông qua quy trình đồng hóa dữ liệu.
Vấn đề nảy sinh khi các mô hình này được đưa vào vận hành thực tế: chúng không còn sử dụng dữ liệu tái phân tích, mà thay vào đó là dữ liệu dự báo thời tiết từ các hệ thống như Hệ thống Dự báo Tích hợp (Integrated Forecasting System - IFS) của ECMWF. Các hệ thống này có đặc điểm khí hậu khác biệt và đi kèm với những độ bất định (sai số) nhất định trong dự báo.
Sự khác biệt này – được gọi là "sự dịch chuyển miền dữ liệu từ tái phân tích sang dự báo" (reanalysis-to-forecast domain shift) – có thể làm giảm đáng kể hiệu suất của mô hình trong điều kiện thực tế. Một mô hình có thể đạt kết quả xuất sắc trong các bài báo nghiên cứu nhưng lại gặp khó khăn khi được áp dụng trong những tình huống quan trọng nhất.
Chiến lược học tập hai giai đoạn
AIFL giải quyết khoảng cách giữa dữ liệu tái phân tích (reanalysis data) và các dự báo vận hành thực tế thông qua phương pháp huấn luyện hai giai đoạn đơn giản nhưng hiệu quả. Trong giai đoạn đầu, chúng tôi huấn luyện trước một mạng thần kinh kiểu "Bộ nhớ dài - ngắn hạn" (Long Short-Term Memory - LSTM) dựa trên dữ liệu tái phân tích ERA5-Land trong 40 năm (1980–2019). LSTM là một dạng mô hình học sâu được thiết kế chuyên biệt để nhận diện các quy luật trong dữ liệu tuần tự, nhờ đó rất phù hợp với các chuỗi thời gian như lượng mưa và lưu lượng dòng chảy trên sông.
Quá trình huấn luyện bao phủ hơn 18.000 lưu vực sông trên toàn thế giới, sử dụng dữ liệu từ CARAVAN – một tập hợp các hồ sơ lưu lượng dòng chảy và đặc điểm lưu vực được cộng đồng xây dựng và chia sẻ công khai. Giai đoạn này giúp mô hình nắm bắt được các mối quan hệ bền vững giữa lượng mưa và dòng chảy trong nhiều điều kiện khí hậu, cảnh quan và hệ thống sông ngòi khác nhau.
Trong giai đoạn thứ hai, chúng tôi tinh chỉnh (fine-tune) mô hình dựa trên các dự báo vận hành từ hệ thống IFS (Integrated Forecasting System) trong giai đoạn 2016–2019. Bước này giúp mạng thần kinh tiếp cận với các cấu trúc sai số và độ chệch (bias) đặc thù của các dự báo thời tiết thời gian thực, từ đó điều chỉnh các biểu diễn nội tại của mô hình cho phù hợp. Kết quả thu được là một mô hình vừa kế thừa kiến thức thủy văn từ hàng thập kỷ dữ liệu nhất quán, vừa được hiệu chỉnh để vận hành hiệu quả trong các điều kiện thực tế.
AIFL đạt hiệu quả như thế nào?
Chúng tôi đã đánh giá AIFL trên một giai đoạn kiểm thử độc lập từ năm 2021 đến 2024 tại 2.000 lưu vực sông có trạm quan trắc. Mô hình đạt giá trị trung vị của chỉ số hiệu quả Kling–Gupta (modified Kling–Gupta Efficiency) là 0,66 – vượt ngưỡng được coi là đạt yêu cầu trong các tài liệu chuyên ngành thủy văn (Hình 1). Đồng thời, tỷ lệ sai lệch lưu lượng (discharge bias ratio) đạt giá trị trung vị gần như hoàn hảo là 1,00, cho thấy mô hình không có xu hướng đánh giá quá cao hay quá thấp một cách hệ thống đối với lưu lượng dòng chảy trên sông.
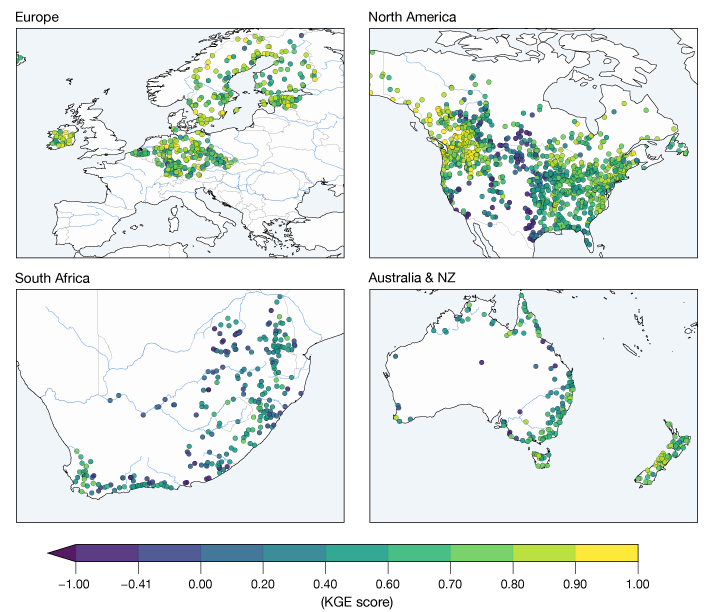 Hình 1: Tổng quan về năng lực dự báo trên phạm vi toàn cầu. AIFL có phạm vi bao phủ rộng khắp, trải dài trên hàng nghìn trạm quan trắc trên toàn thế giới. Phân tích của chúng tôi tập trung vào bốn khu vực chính: Châu Âu, Bắc Mỹ, Nam Phi, cùng Úc và New Zealand. Tại các khu vực này, mô hình liên tục thể hiện hiệu suất cao; nhiều trạm đạt chỉ số Hiệu quả Kling–Gupta (KGE′) vượt xa ngưỡng 0,5 – mức được coi là "có năng lực dự báo tốt" – qua đó khẳng định độ tin cậy của mô hình trong nhiều điều kiện khí hậu và địa hình khác nhau.
Chúng tôi cũng đã so sánh AIFL với mô hình dự báo lũ toàn cầu của Google tại hơn 1.200 trạm quan trắc chung. Kết quả cho thấy AIFL đạt hiệu suất tương đương hoặc vượt trội hơn so với mô hình của Google tại 43% số địa điểm; điều này chứng tỏ AIFL có khả năng cạnh tranh tốt, đồng thời vẫn còn dư địa để tiếp tục cải thiện. Chúng tôi nhận thấy hiệu suất thay đổi tùy theo quy mô lưu vực: AIFL đặc biệt hiệu quả tại các lưu vực nhỏ và duy trì khả năng dự báo ổn định, nhất quán trên mọi quy mô.
Đối với việc phát hiện các sự kiện lũ lụt, mô hình này có xu hướng khá thận trọng. Khi AIFL đưa ra cảnh báo lũ, gần như chắc chắn đó là một sự kiện lũ thực tế – chúng tôi ghi nhận không có trường hợp báo động giả nào đối với các chu kỳ lặp lại lên đến 50 năm. Độ tin cậy cao này đi kèm với một hạn chế là mô hình có thể bỏ sót một số sự kiện, đặc biệt là những trận lũ cực hiếm. Việc cải thiện khả năng phát hiện các trận lũ cực đoan mà không làm gia tăng các cảnh báo giả chính là ưu tiên hàng đầu cho các nghiên cứu trong tương lai.
Thử nghiệm thực tế: Bão Henk
Vào tháng 1 năm 2024, bão Henk đã gây ra tình trạng lũ lụt nghiêm trọng tại một số khu vực ở Bỉ. Tại trạm Straimont – nằm trên một lưu vực có diện tích 182 km² – AIFL đã dự báo chính xác tín hiệu lũ từ sáu ngày trước khi đỉnh lũ thực tế xuất hiện; đây là sự kiện có chu kỳ lặp lại khoảng 20 năm một lần (Hình 2). Mặc dù cường độ dự báo có sự thay đổi nhẹ tùy theo khoảng thời gian dự báo trước (lead time), nhưng sự kiện này đã được phát hiện một cách rõ ràng từ rất sớm. Điều này minh chứng cho giá trị thực tiễn từ chiến lược phát hiện lũ mang tính thận trọng nhưng đáng tin cậy của mô hình.
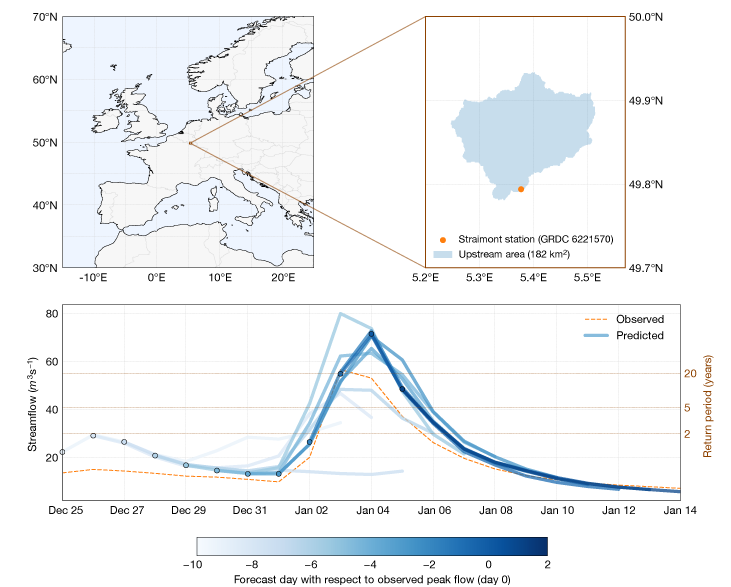 Hình 2: Nghiên cứu điển hình về dự báo lũ trong cơn bão Henk (tháng 1 năm 2024) tại một trạm đo trên sông ở Bỉ. Lưu lượng dòng chảy thực tế (đường đứt nét màu cam) được hiển thị cùng với các dự báo từ AIFL ở những khoảng thời gian dự báo khác nhau (các sắc thái màu xanh dương; màu càng đậm tương ứng với khoảng thời gian dự báo càng ngắn). Mô hình đã phát hiện tín hiệu về trận lũ có chu kỳ lặp lại khoảng 20 năm một lần trước thời điểm xảy ra tới sáu ngày.
Tại sao AIFL lại quan trọng?
Ngay từ khi bắt đầu, AIFL đã được thiết kế để tích hợp vào các quy trình dự báo thời gian thực tại ECMWF. Bằng cách giải quyết vấn đề sai lệch miền dữ liệu (domain shift) giữa giai đoạn tái phân tích và giai đoạn dự báo thông qua một chiến lược huấn luyện đơn giản và có khả năng tái lập, AIFL cung cấp một cơ sở tham chiếu minh bạch, bổ sung cho các hệ thống hiện có như GloFAS. Mô hình này được phát triển bằng thư viện Python "Neural Hydrology" và huấn luyện trên tập dữ liệu CARAVAN, đảm bảo một khuôn khổ vững chắc và có thể tái lập cho cộng đồng nghiên cứu rộng lớn hơn.
Trong tương lai, chúng tôi dự định mở rộng AIFL bằng cách bổ sung các kết quả đầu ra dạng xác suất để định lượng độ không chắc chắn, khám phá các nguồn dữ liệu lượng mưa đa dạng nhằm cải thiện khả năng phát hiện sự kiện lũ, đồng thời thực hiện các so sánh hệ thống với GloFAS. Bằng cách kết hợp thế mạnh của học máy với cơ sở hạ tầng vận hành tại ECMWF, chúng tôi hướng tới việc mở rộng giới hạn của những gì có thể đạt được trong lĩnh vực dự báo lũ trên phạm vi toàn cầu.
Tin ngắn: Phòng Thông tin KTTV phục vụ cộng đồng
Nguồn: https://www.ecmwf.int/en/about/media-centre/aifs-blog/2026/aifl-global-streamflow-prediction